客户某跨国企业招聘团队(匿名)
行业跨行业(外企)
场景规模旺季单岗位 300+ 份简历
使用角色招聘 HR 4 人 · 用人经理
交付形态FDE + AI 工程师
周期2 周
-85%
初筛耗时
实测
3 天 → 4 小时 / 岗位
300 → 20
简历筛选结果
实测
3 个岗位均值
可追溯
每条评分有依据
硬项 / 加分 / 否决三类
48h
候选人反馈时效
原为不固定
数字口径:实测来自客户后台或验收报告;推算为样本外推;基准为公开研究。
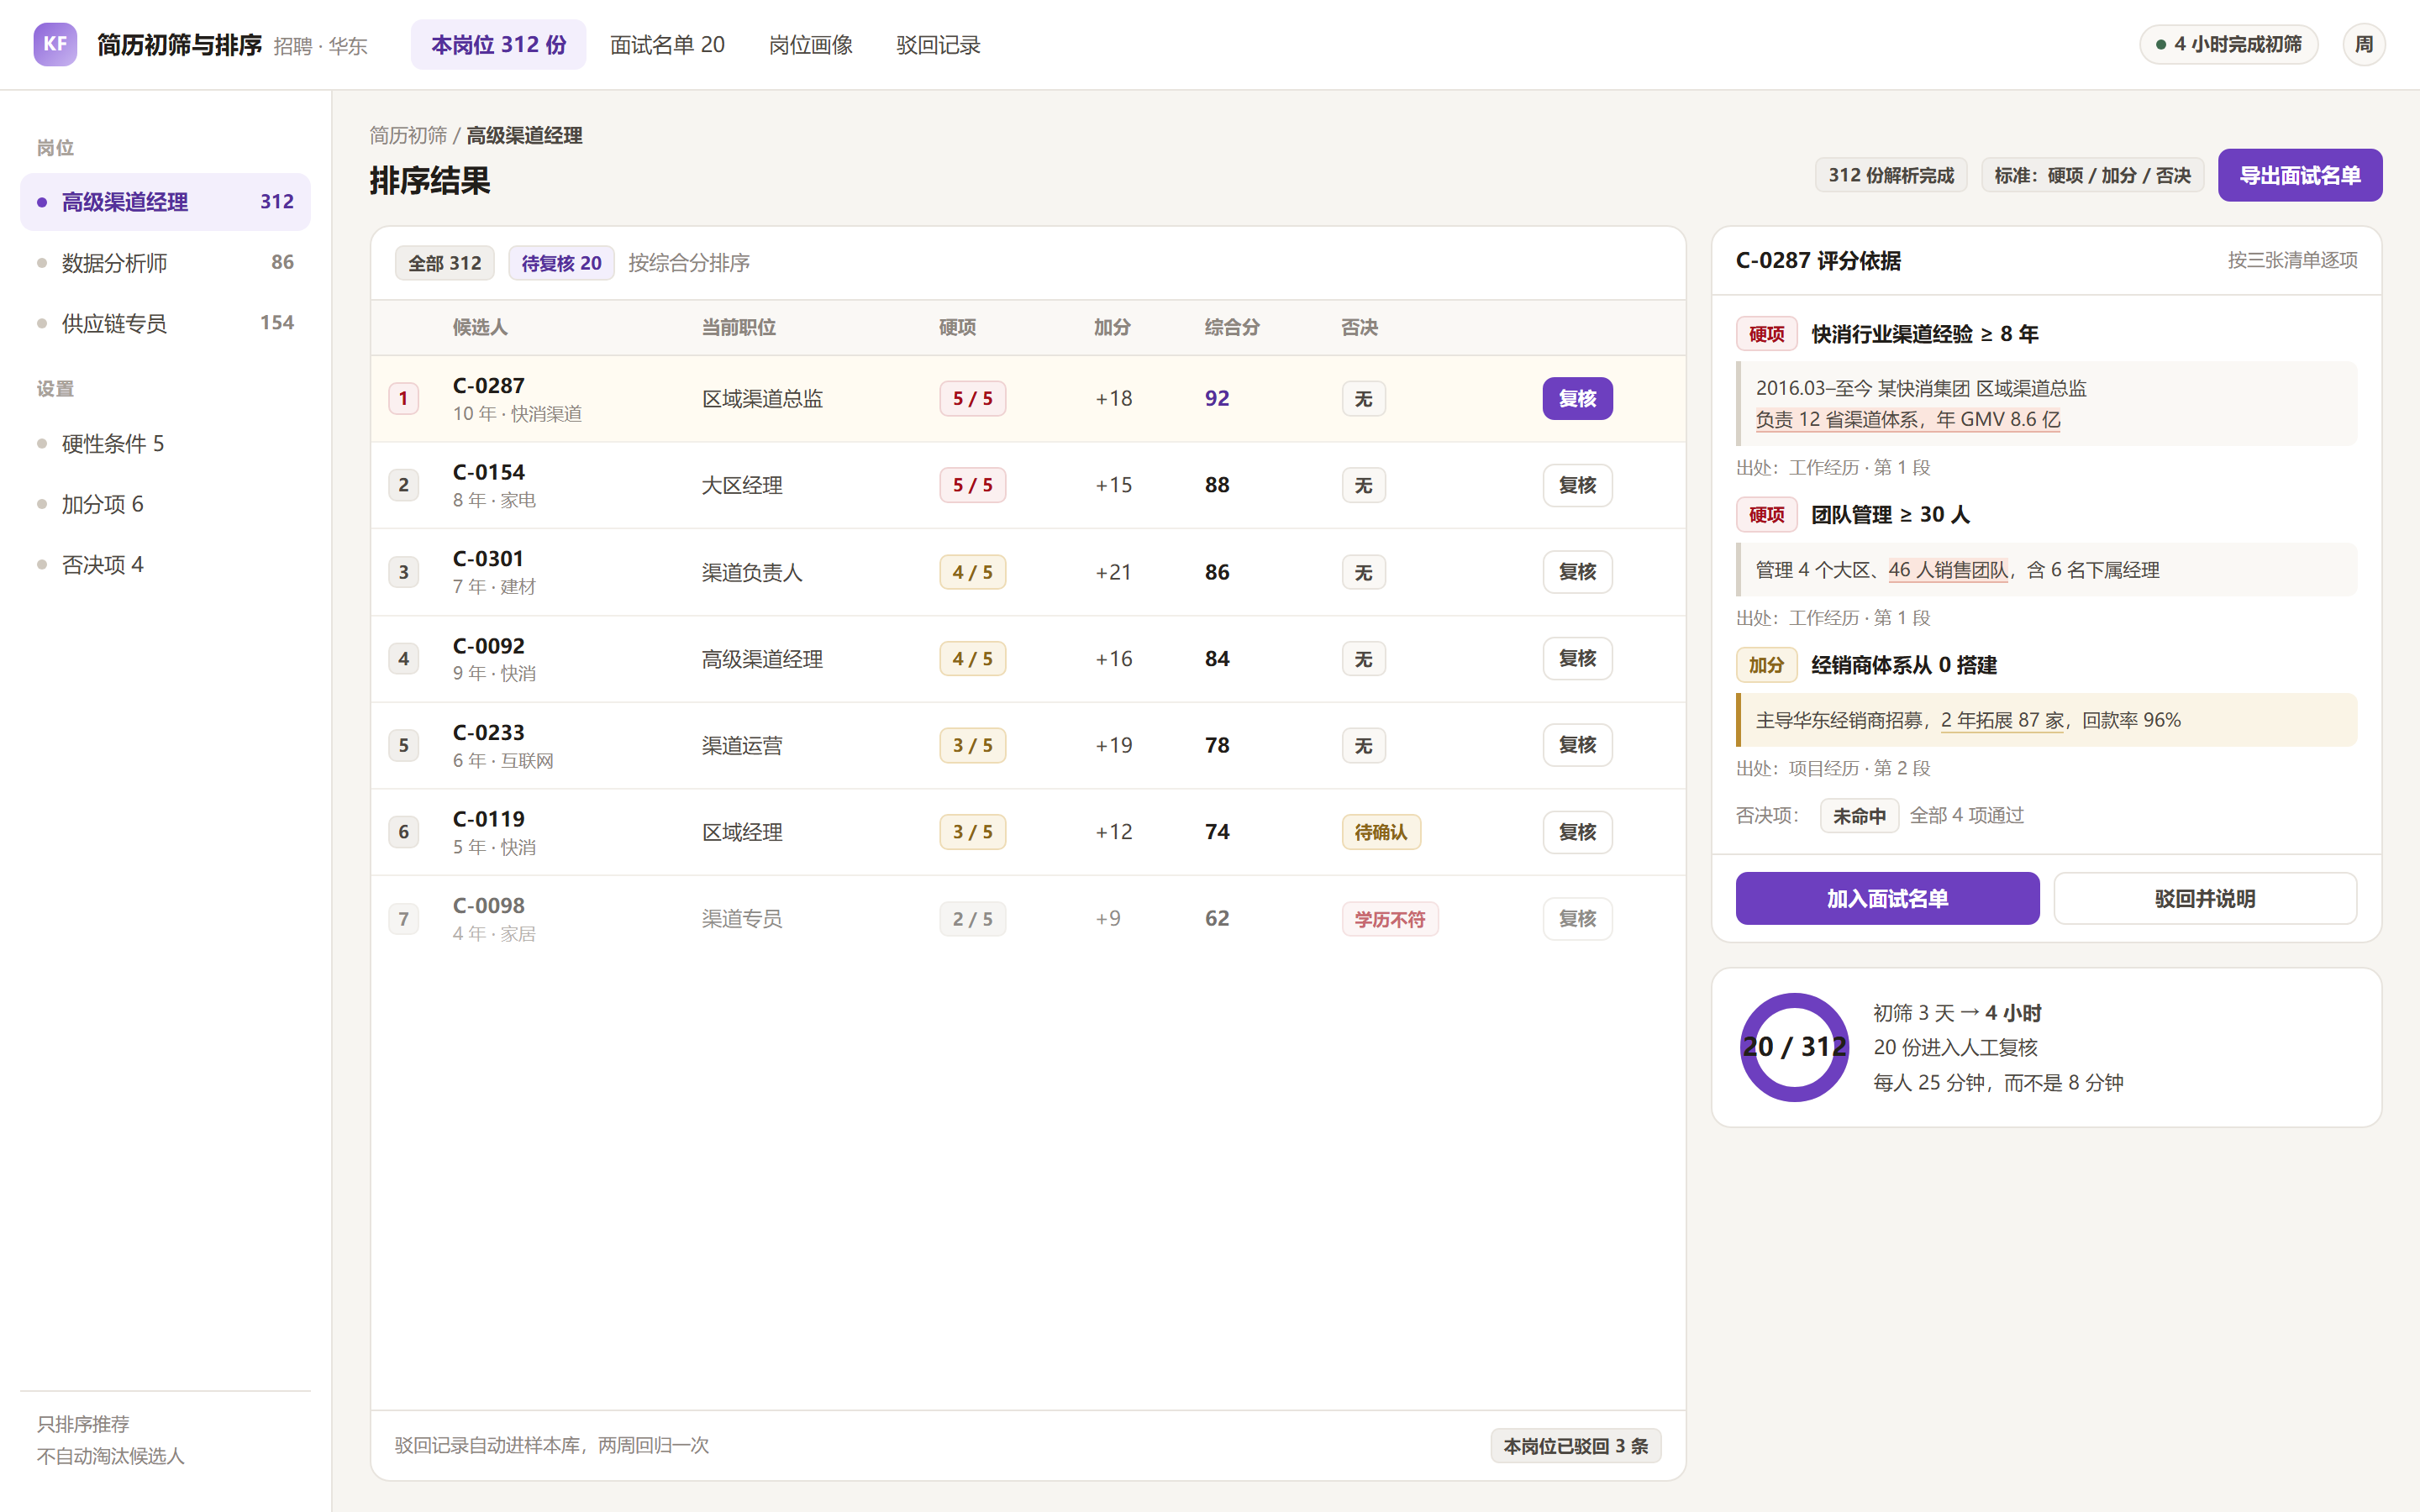
简历初筛 · 界面示意 · 数据已脱敏
Why now
如果不做,会发生什么
- 01
旺季单个岗位收到 300 多份简历,4 个 HR 全月在看简历,面试官却在等。
- 02
初筛标准依赖个人经验,不同 HR 筛出的名单差异很大,用人经理经常质疑「这个人为什么没进面试」。
- 03
筛选过程没有任何记录。事后问「为什么这个人没进面试」,谁也答不上来。
Trade-offs
关键取舍
1
先把岗位要求拆成硬性条件 / 加分项 / 否决项三张清单
为什么这么选
不拆清楚,模型只会输出一个无法反驳的总分。拆清楚之后,每一条分数都能指回具体事实。
代价是什么
需要用人经理参与 2 次、每次 1 小时。他们通常最不愿意给这个时间。
2
只做排序与推荐,不做自动淘汰
为什么这么选
自动淘汰一旦误伤,候选人永远不知道自己被谁筛掉,品牌风险不可控。
代价是什么
HR 仍要人工过一遍 20 份,节省的是 280 份的时间,不是全部时间。
Timeline
落地节奏
W1
岗位画像
与用人经理拆出三张清单,标注每项的判定依据。
W1
结构化解析
简历解析成统一字段,消除格式差异对判断的影响。
W2
打分与复核台
输出排序表 + 评分依据,HR 可逐条采纳或驳回。
W2
坏例回流
驳回记录进样本库,两周一次回归。
Results
结果
| 指标 | 之前 | 之后 |
|---|---|---|
| 初筛耗时 | 约 3 天 / 岗位 | 约 4 小时 / 岗位 |
| 面试名单质量 | 依赖个人经验 | 按统一标准,可解释 |
| 筛选记录 | 无 | 完整留痕,可复盘 |
| 候选人体验 | 等待时间长 | 48 小时内反馈 |
Not good enough
一项没达到预期的
跨行业跳槽候选人的「可迁移能力」判断仍偏保守,容易漏掉转型型人才。目前靠 HR 手动捞回,还没做到自动识别。
它不替我们做决定,但把 300 份变成 20 份,我们才有时间认真看那 20 份。以前我们是在 300 份里平均分配 8 分钟,现在是在 20 份里每人 25 分钟。
Reusable
这个项目留下了什么
- 岗位画像三张清单模板
- 简历结构化解析字段规范
- 评分依据展示组件
- 驳回样本回流机制
Next
这套做法还能用在哪
- 岗位画像三张清单可直接用于同类销售岗,换的是硬项与加分项。
- 评分依据展示组件已复用到渠道与供应链岗位的初筛。
- 驳回样本回流机制可迁移到任何「有判据」的排序场景。
模板与连接器可以直接复用,相邻场景不必从零开发。
Stack
聊聊我的场景
大模型简历解析低代码审核台权限控制
Related
相似场景
61% → 92%RAG 知识库
命中率 61% → 92%:我们没换模型,先花了 4 周治理文档
第一版上线命中率只有 61%,其中 70% 的错误来自文档本身存在三个版本。这个案例的重点不是 RAG 技术,而是上 AI 之前先做文档治理是否值得。
92%问答命中率
3天 → 4小时AI 合同审核
3 天 → 4 小时:某金融机构把 4000 份合同交给 AI 初筛
关键不是做一个会读合同的工具,而是先把法务的判断标准写下来,再交给系统执行。顺序反过来,我们走过两次弯路。
3天 → 4小时平均审核周转
5 模块 · 1 入口员工服务台
5 个入口收成 1 个:Teams 里的员工服务台
员工无需安装新应用或记住新网址,餐饮、车位、名片、邮寄、问询统一在一个窗口办理,审批状态可自助查询。
-60%行政咨询量