数字口径:实测来自客户后台或验收报告;推算为样本外推;基准为公开研究。
如果不做,会发生什么
- 01
业务扩张后合同量三年翻了 2.6 倍,法务人数没变。平均周转从 1 天拖到 3 天,销售侧开始出现「先签后报」——合规风险从流程里长出来了。
- 02
监管检查要求能回答「谁在什么时候审过哪一条」,纸质登记本只能证明「有人签过字」,证明不了审过什么。
- 03
6 名审核员对同类条款有 4 套尺度。同一份合同换个人审,结论可能相反,业务方对结果没有稳定预期。
我们判断错的两件事
瓶颈是「读得慢」,所以先做阅读加速:自动摘要 + 关键字段提取。
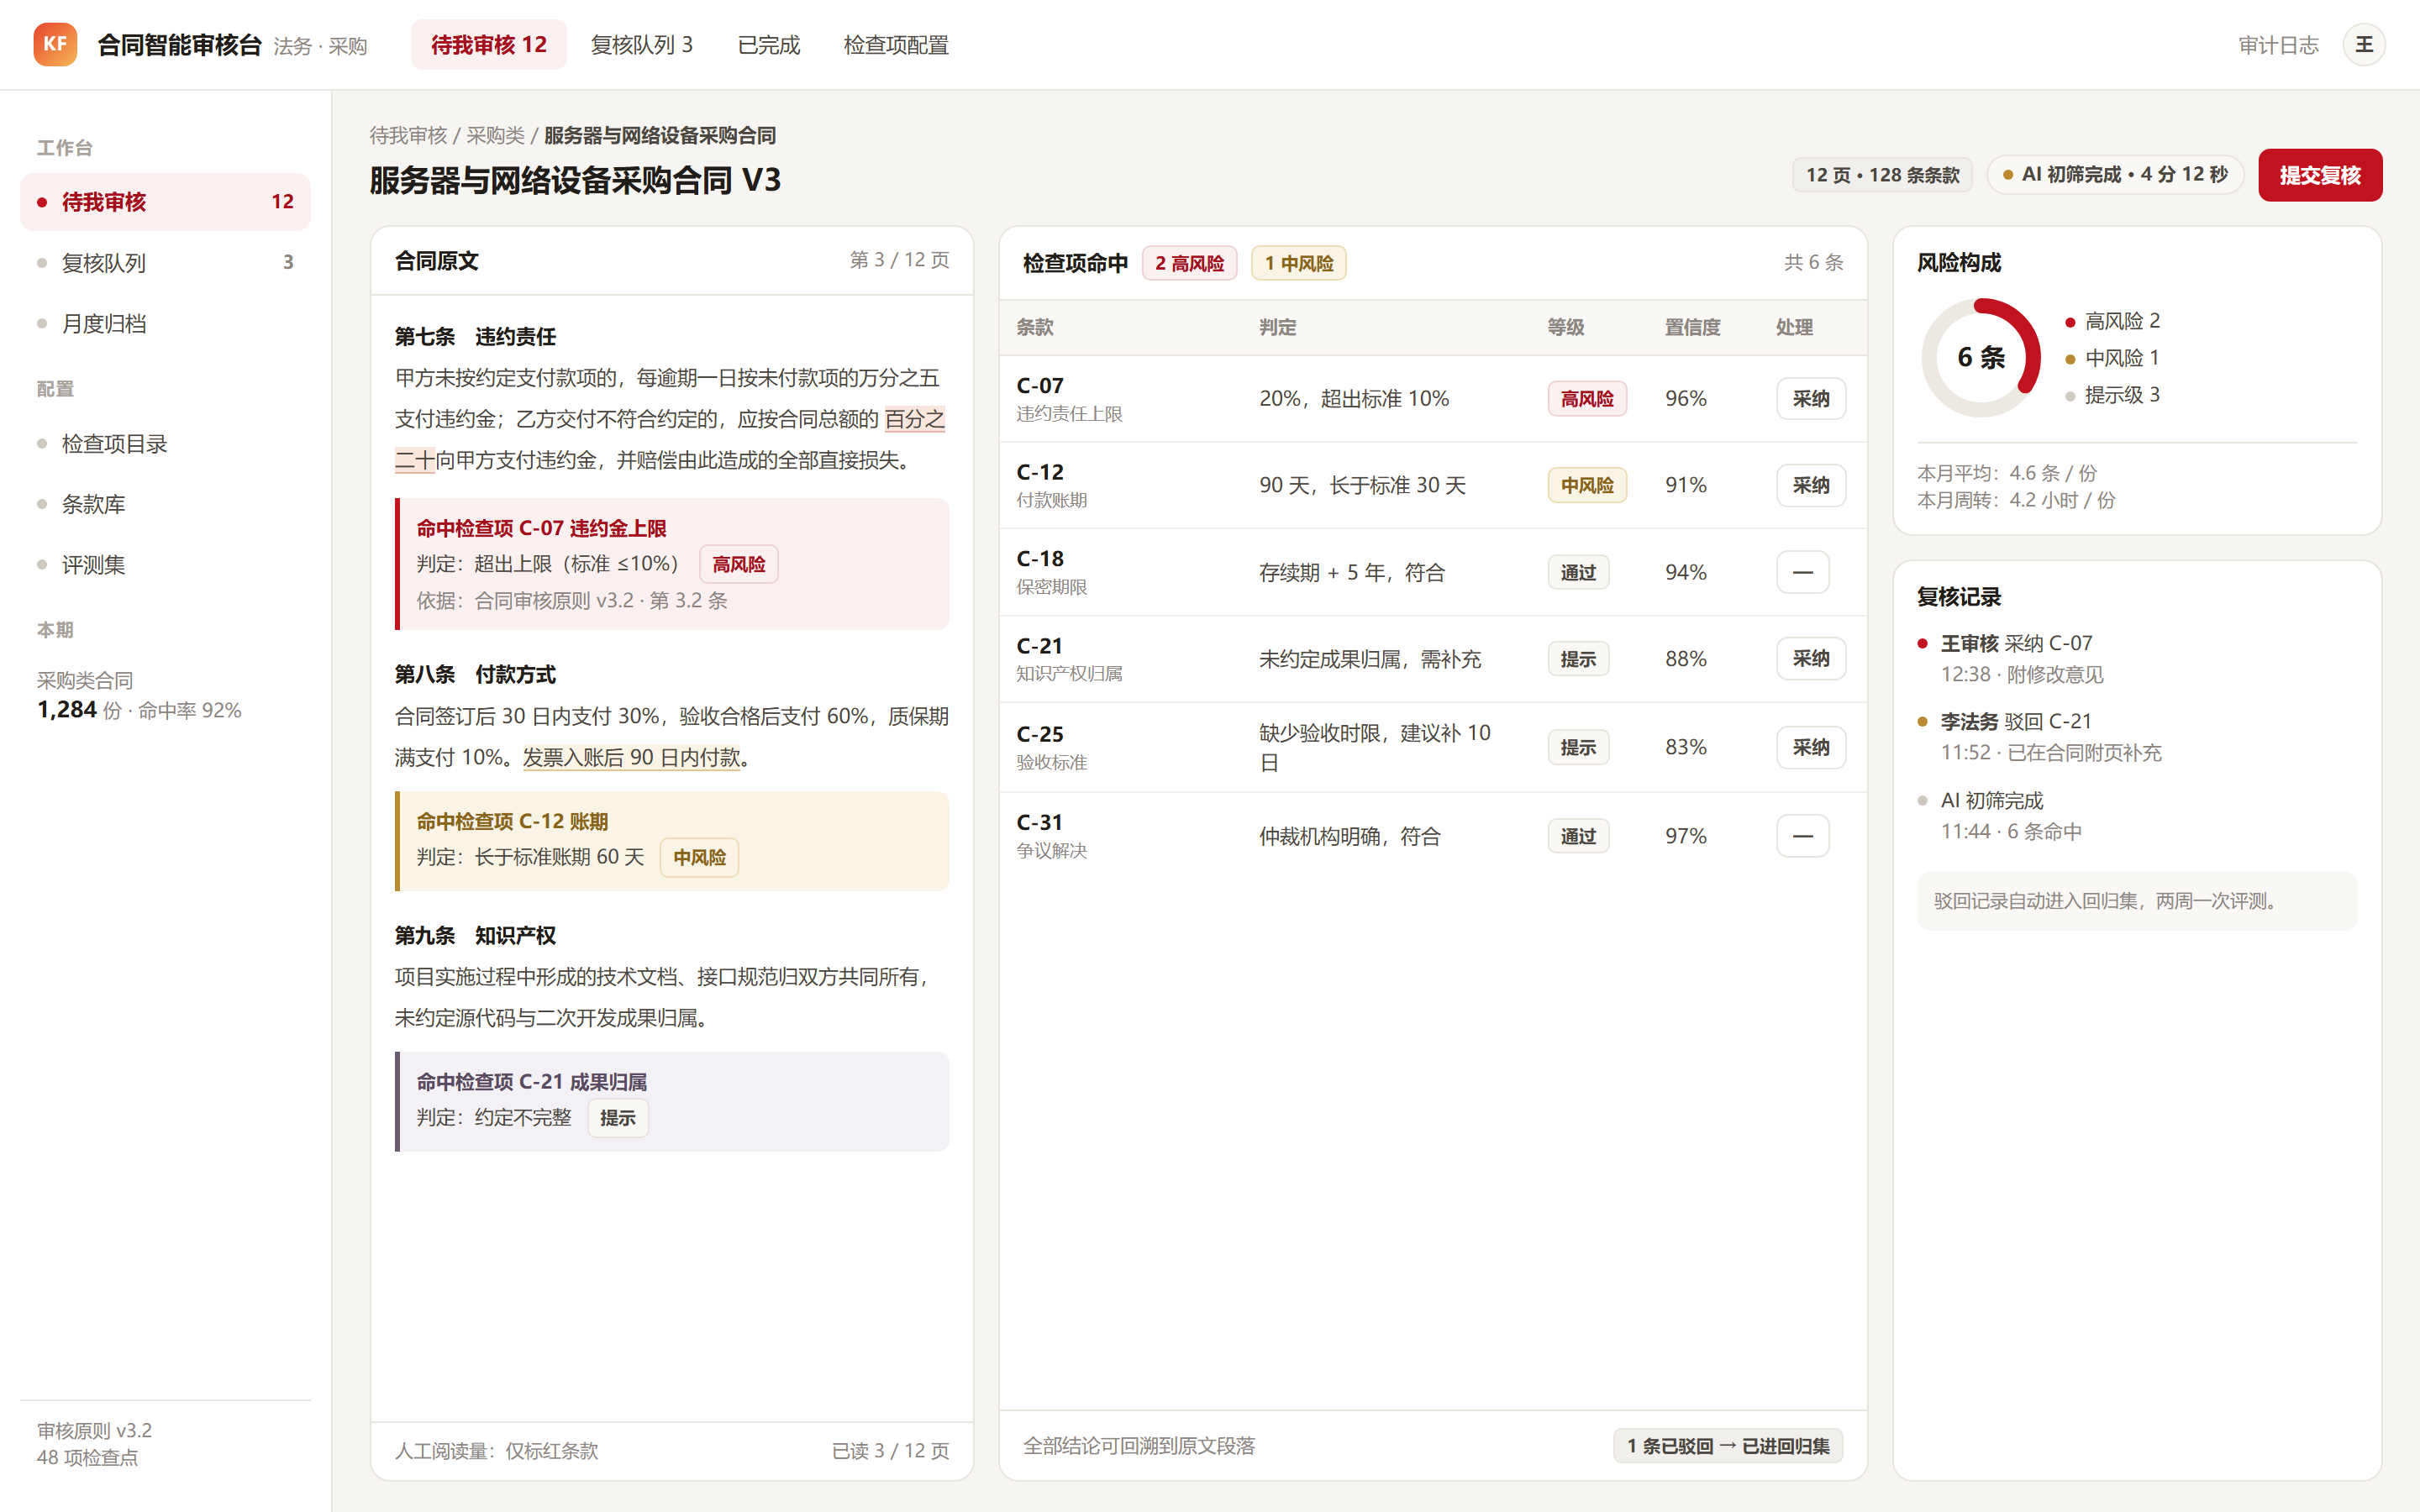
审核时长只降了 12%。真正的瓶颈是判断标准不统一——「违约金上限是否合理」这一条,6 个人有 4 套尺度。加速阅读只是让 4 套尺度更快地产出 4 个答案。
应该按合同类型(采购 / 销售 / 服务 / 保密)分类建模。
客户实际是按「签约主体风险等级」组织工作的。分类方式错了,规则命中率只有 41%,整个 POC 返工 3 周。这件事是在第 3 天现场跟岗时发现的,比任何需求文档都直接。
关键取舍
规则引擎 + 模型双通道,而不是纯模型
法务能接受「漏检率略高但要能复核」,不能接受「每次都要从头读一遍」。规则负责确定项,模型负责语义判断项。
规则需要持续维护。我们把维护权交给客户法务,我们只做季度校准——这意味着后续问题不能靠「再训一次模型」解决,必须靠流程。
只做条款级标注与修改建议,不做全文重写
全文改写会引出合同效力与授权范围的争议,客户合规部门明确不接受。工具一旦越界,法务就不敢用。
输出形态更「笨」。销售演示时不如「一键生成新合同」好看,我们放弃了那个演示效果。
用客户历史 800 份已审合同做评测集,不用公开数据集
通用数据集上的准确率与这家机构的条款体系无关,评测集必须来自它自己的判例。
建评测集吃掉了整个 POC 一半的时间,客户内部一度认为「怎么还在标数据」。
落地节奏
跟 3 名审核员各坐 1 天,抽出 6 类高频风险条款,把口头判断写成可执行的检查项。
200 份历史合同盲评,输出准确率、漏检率、单次调用成本三条硬指标。
把 4 套尺度收敛成 1 套,逐条与法务确认判定标准。这一步比模型难。
接入 OA 审批流,加权限、审计日志与人工兜底队列。
每周复盘标红项的采纳率,按月回归测试,坏例回流成样本。
结果
| 指标 | 之前 | 之后 |
|---|---|---|
| 平均审核周转 | 3 天 | 4 小时 |
| 单份人工阅读量 | 全部条款 | 仅标红条款(约 15%) |
| 同类风险漏检 | 依赖个人经验 | 按检查项全覆盖 |
| 审核记录 | 纸质 / 邮件 | 结构化留痕,可按条款检索 |
一项没达到预期的
跨境合同的多语种条款识别只做到 78%,未达 90% 目标,最终退回「人工优先 + AI 辅助」。这条能力我们仍在迭代,暂不对外承诺。
一开始我们最担心它把该拦的漏掉。跑了三个月,真正改变的不是速度,是我们终于有了一套写下来的标准——以前标准在每个人脑子里,现在在系统里,新人第一周就能按同一套尺度审。
这个项目留下了什么
- 6 类风险条款检查项模板(可直接改成采购 / 销售版本)
- 分层评测集:致命 / 重要 / 提示三级,用于算漏检代价
- 双通道审核台组件:规则命中 + 模型判断 + 人工复核队列
- 坏例回流机制:每一次采纳 / 驳回都进回归集
这套做法还能用在哪
- 采购合同与销售合同的条款库可直接复用,换的是检查项,不是平台。
- 「条款级标注」这套交互已迁移到报关单与保单审核,人机分工逻辑一致。
- 评测集方法可迁移到任何「有判据」的文档场景:简历、工单、质检记录。
模板与连接器可以直接复用,相邻场景不必从零开发。
相似场景
命中率 61% → 92%:我们没换模型,先花了 4 周治理文档
第一版上线命中率只有 61%,其中 70% 的错误来自文档本身存在三个版本。这个案例的重点不是 RAG 技术,而是上 AI 之前先做文档治理是否值得。
单证录入量 -90%:发票与报关单的混合识别流水线
OCR 负责定位,大模型负责字段理解。新增单据类型当天可接入,不需要重新训练模板。
用章审批 5 天 → 4 小时:把线下传递整段拿掉
预算、比价、盖章、签约、付款连成一条线上链路,供应商可自助查询进度。