数字口径:实测来自客户后台或验收报告;推算为样本外推;基准为公开研究。
如果不做,会发生什么
- 01
售后现场要查工艺规范,平均 25 分钟才能确认手上这份是不是最新版。查错版本导致的返工,一年 30 多次。
- 02
6 条产品线的文档散在共享盘、邮件和个人电脑里。老师傅一退休,一段工艺知识就没了。
- 03
新员工上手要 6 周,方式是「问老同事」。同一个问题,三个人给三个答案,新人不知道信谁。
我们判断错的两件事
先上模型,靠调切分策略和提示词把准确率拉上去。
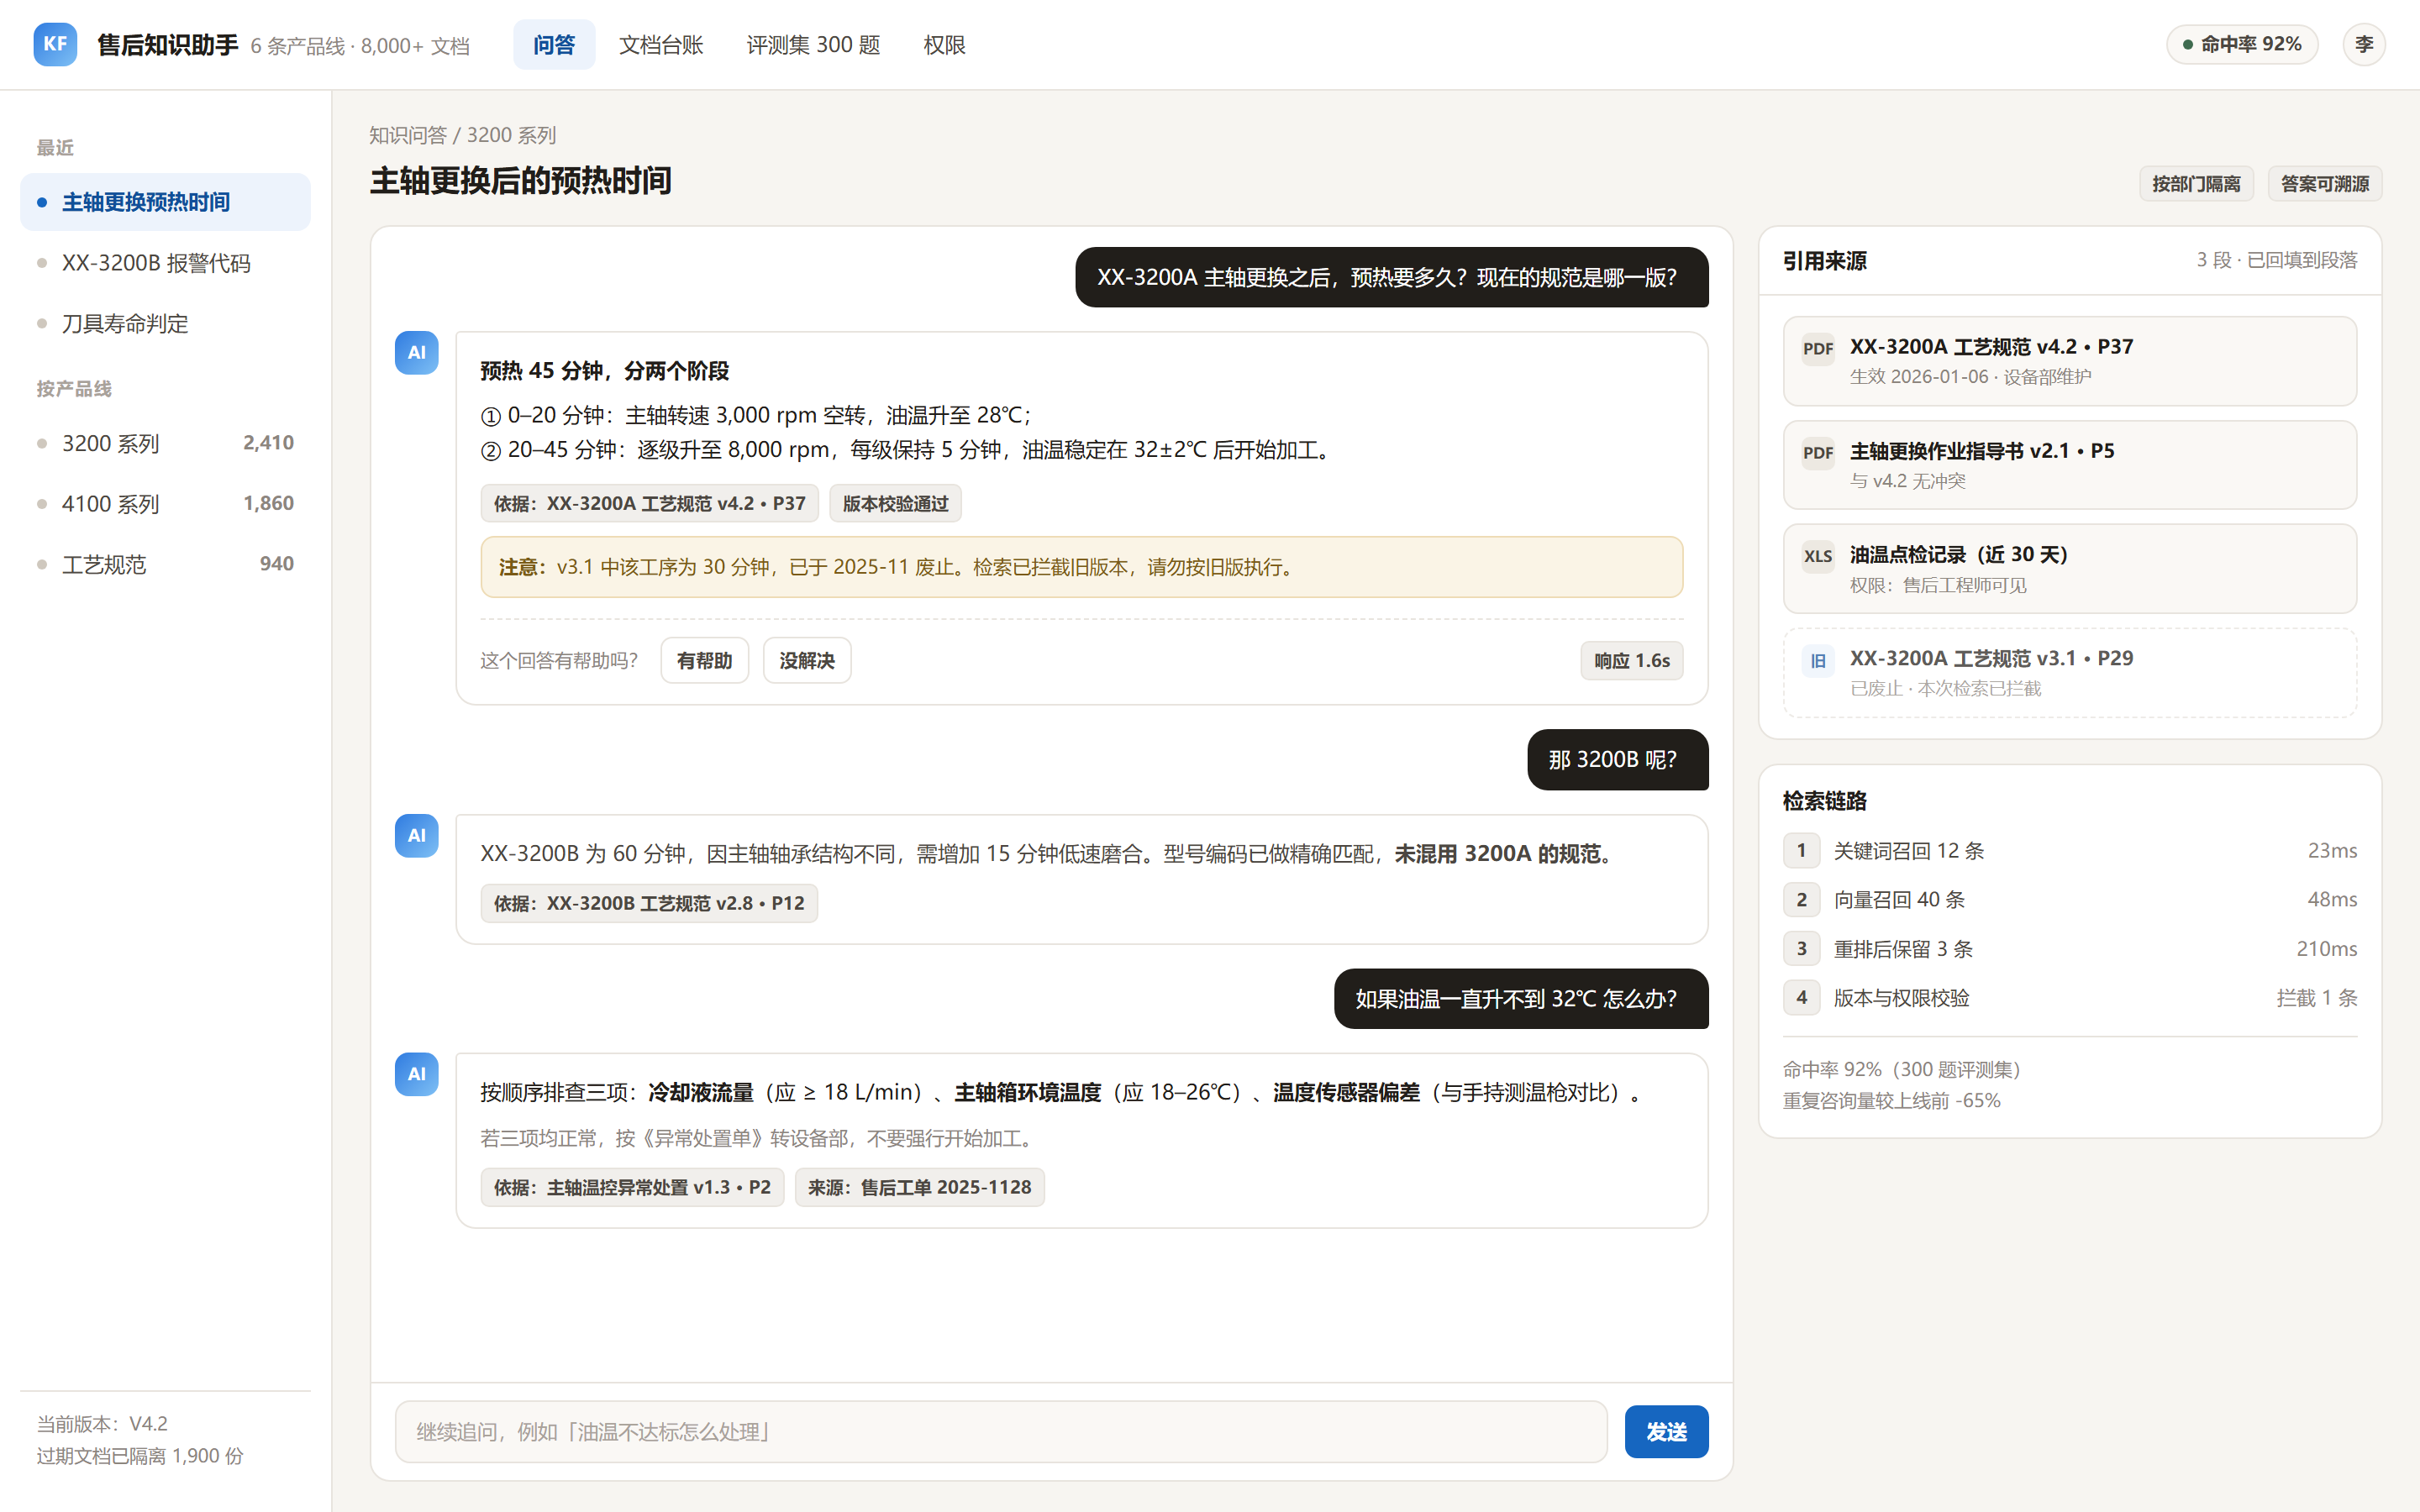
首版命中率 61%。把错误样本拆开看,70% 是「文档本身有三个版本,检索召回了错的那份」。模型再准,喂进去的是过期规范也只能答错。
关键词检索够用,向量检索只是加分项。
型号编码(如 XX-3200A)在向量空间里几乎不可分,纯向量检索会把 3200A 和 3200B 的规范混起来。最终必须保留关键词通道,做混合召回。
关键取舍
先做 4 周文档治理,再写一行 AI 代码
8,000 份里有 1,900 份是过期版本。删掉错版本,比任何检索优化都有效。
整整 4 周没有可演示的界面,客户内部一度质疑「项目是不是停滞了」。这 4 周必须提前和客户高层对齐,否则撑不过去。
混合检索 + 重排,而不是换更大的模型
检索准了,小模型也答得对;检索不准,大模型只会更自信地答错,还更贵。
链路更长,响应时间从 1.2s 涨到 2.4s。靠缓存与并行召回压回 1.6s,工程量翻了一倍。
每条回答强制带原文段落与文档链接
售后工程师是站在客户面前回答问题的,他需要自己判断可信度,不能替客户承担一个「AI 说可以」的结论。
前端不能做「一句话结论」的漂亮形态,界面看起来比同类产品笨重。
落地节奏
按产品线 × 版本 × 密级建台账,标出重复、过期、无人维护三类。
清理 1,900 份过期文档,统一命名与版本号,补齐密级标注。
从真实售后工单里抽 300 题,人工标注标准答案与出处。
关键词 + 向量混合召回,加重排,出处回填到段落级。
按部门隔离知识库,检索前后各做一次权限过滤,日志可审计。
结果
| 指标 | 之前 | 之后 |
|---|---|---|
| 问答命中率 | 61%(首版) | 92%(300 题评测集) |
| 重复咨询量 | 基准 | -65% |
| 新员工上手 | 约 6 周 | 约 3 周 |
| 过期文档引用 | 偶发且无法发现 | 版本强校验,命中即提示 |
一项没达到预期的
表格类文档(工艺参数表)的问答仍不稳定,跨表推理经常错行。我们试过表格结构化方案,成本高于收益,最终只支持单表查询,暂不承诺多表推理。
最有价值的不是那个聊天框,是趁机把文档版本清了一遍。这件事我们内部提了三年没做成,借着上 AI 做成了。现在回头看,那 4 周才是这个项目的主体。
这个项目留下了什么
- 文档台账模板:产品线 × 版本 × 密级三维清单
- 300 题分层评测集:基础事实 / 专有名词 / 跨文档推理
- 混合检索参考实现:关键词 + 向量 + 重排三段式
- 权限过滤中间件:检索前后双校验,可复用到任何多租户场景
这套做法还能用在哪
- 同一套检索链路已用于 IT 服务台与 HR 政策问答,换的是语料和权限模型。
- 文档台账模板可直接复用于 ISO / GxP 审计前的资料整理。
- 评测集方法可迁移到客服知识库与投标资料库——凡是有「标准答案」的问答都适用。
模板与连接器可以直接复用,相邻场景不必从零开发。
相似场景
3 天 → 4 小时:某金融机构把 4000 份合同交给 AI 初筛
关键不是做一个会读合同的工具,而是先把法务的判断标准写下来,再交给系统执行。顺序反过来,我们走过两次弯路。
5 个入口收成 1 个:Teams 里的员工服务台
员工无需安装新应用或记住新网址,餐饮、车位、名片、邮寄、问询统一在一个窗口办理,审批状态可自助查询。
初筛 3 天 → 4 小时:把 300 份简历筛成 20 份面试名单
系统不替 HR 做决定,只解决看不过来的问题。关键不是打分,而是每条分数都有依据。